Content-Lokalisierung: Den Freigabe-Workflow richtig aufsetzen
Jack Clawson
Dictem Redaktion
16. September 2026
12 Min.
Kurz gefasst
Ein sauber definierter Freigabe-Workflow entscheidet in der Enterprise-Lokalisierung über Tempo, Qualität und ROI. Der Artikel zeigt Rollen, Qualitätsschwellen und In-Country-Review-Praktiken, mit denen Studios mehrsprachige Inhalte skalieren, ohne die Kontrolle zu verlieren.
Inhaltsverzeichnis
- Warum der Freigabe-Workflow über Lokalisierungs-ROI entscheidet
- Rollen und Verantwortlichkeiten sauber definieren
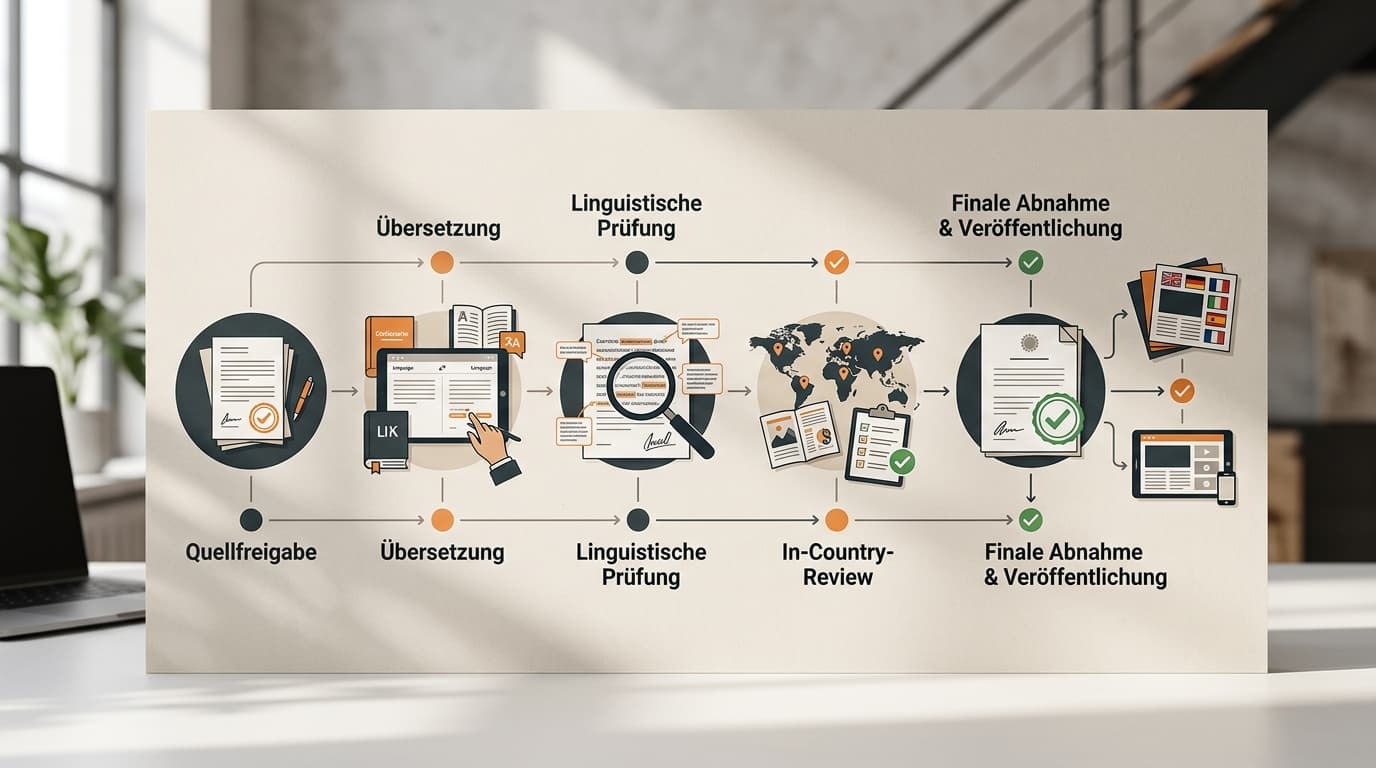
- Der Kern-Workflow: Von der Quellfreigabe bis zur Veröffentlichung
- In-Country-Review als Qualitätsschritt richtig einsetzen
- Qualität messbar machen: LQA-Scores und Abnahmekriterien
- Feedback-Schleifen und Versionierung beherrschen
- Skalieren: Automatisiertes Routing mit menschlicher Endabnahme
- Häufige Fragen
- Quellen
Das Wichtigste
- 96 % der Marketer melden positiven ROI durch Lokalisierung, 65 % sogar das Dreifache oder mehr (DeepL-Studie 2023-2024).
- 99 % kombinieren maschinelle Übersetzung mit menschlicher Prüfung: Die Freigabe bleibt ein Human-in-the-Loop-Prozess.
- Zentralisiertes Feedback beschleunigt Freigaben um bis zu 50 % und halbiert die Zahl der Revisionsschleifen.
- 82 % sehen Branchenterminologie als größte Hürde: Glossare und Styleguides gehören in den Workflow, nicht daneben.
- Die Umsätze der Sprachdienstleister sanken 2023 auf 51,85 Mrd. US-Dollar, erstmals unter das Vorjahresniveau (CSA Research).
Warum der Freigabe-Workflow über Lokalisierungs-ROI entscheidet
Die Ökonomie der Lokalisierung hat sich verschoben. In einer DeepL-Studie mit Regina Corso Consulting berichteten 96 % der befragten Marketingverantwortlichen von einem positiven ROI ihrer Lokalisierungsprojekte, 65 % erzielten sogar mindestens den dreifachen Einsatz zurück[1]. Gleichzeitig schrumpfte der Markt für klassische Sprachdienstleistungen: Die Umsätze der Anbieter sanken laut CSA Research von 52,01 Mrd. US-Dollar (2022) auf 51,85 Mrd. US-Dollar (2023)[2]. Maschinelle Übersetzung drückt die Stückkosten, während die Inhalte mengenmäßig explodieren. Der Engpass wandert damit von der Übersetzung selbst zum Prozess drumherum: zur Frage, wer wann was freigibt.
Ohne definierten Freigabe-Workflow zeigt sich das immer im selben Fehlerbild. Teams verlieren Wochen nicht an die Übersetzung, sondern an die Koordination danach:
- Versionschaos: Reviewer kommentieren veraltete Entwürfe, weil niemand weiß, welche Datei aktuell ist.
- Endlosschleifen: Unklare Kriterien führen dazu, dass dieselbe Passage dreimal hin- und hergereicht wird, ohne dass jemand das formale Zeichen erteilt.
- Doppelte Prüfungen: Zwei Stellen prüfen aus Gewohnheit dasselbe, während ein risikoreicher Inhalt niemandem eindeutig gehört.
- Verzögerte Launches: Der Inhalt ist übersetzt, aber wartet wegen eines fehlenden, nicht benannten Freigebers im Status 'in Klärung'.
Die These dieses Artikels lautet daher: Der Freigabepunkt ist der Hebel für Tempo und Qualität zugleich. Maschinelle Übersetzung liefert Rohgeschwindigkeit nahezu kostenlos; ob daraus ein marktfähiger Inhalt wird, entscheidet sich an den menschlichen Übergaben. Wer Rollen, Qualitätsschwellen und In-Country-Review von Anfang an sauber definiert, skaliert mehrsprachige Inhalte ohne Qualitätsverlust und verwandelt den ROI-Vorteil der KI in tatsächlich veröffentlichte Inhalte.
Rollen und Verantwortlichkeiten sauber definieren
Strukturierte Content-Freigabeprozesse beginnen nicht mit Tools, sondern mit einer Rollenmatrix: Wer darf Inhalte anfordern, wer übersetzt und redigiert, wer prüft fachlich, rechtlich und sprachlich, und wer erteilt am Ende das formale Zeichen? Enterprise-Leitfäden empfehlen dafür, je Beteiligtem festzuhalten, welche Aufgaben er hat und welche Prüf- oder Freigabebefugnis damit verbunden ist[3]. Genau diese Unterscheidung zwischen Feedback geben und verbindlich abnehmen ist der wichtigste Hebel gegen Endlosschleifen: Feedback kann widersprüchlich sein, eine Freigabe nicht.
| Rolle | Kernaufgabe | Entscheidungsbefugnis |
|---|---|---|
| Anforderer | Inhalt beauftragen, Briefing und Zielmarkt definieren | Keine Freigabe, aber Rückzug des Auftrags |
| Lokalisierungsmanager | Workflow steuern, Fristen überwachen, Eskalationen entscheiden | Prozessverantwortung, Weitergabe an nächste Stufe |
| Übersetzer bzw. Post-Editor | Übersetzen, maschinelle Entwürfe nachbearbeiten | Fachliche Freigabe der Sprachfassung |
| Fachexperte (SME) | Terminologie, Produktaussagen und technische Korrektheit prüfen | Inhaltliche Rückweisung mit Begründung |
| Legal/Compliance | Regulatorische Risiken, Haftungsausschlüsse, Datenschutz prüfen | Veto bei Compliance-Verstößen |
| Finaler Approver | Formale Abnahme je Sprache und Inhaltstyp | Verbindliches Zeichen zur Veröffentlichung |
Drei Regeln halten diese Matrix praktikabel. Erstens: Rollen nach Expertise zuweisen, nicht nach Hierarchie, denn die beste Person für die japanische Marketingfassung ist selten die ranghöchste. Zweitens: Zuständigkeiten je Sprache und Inhaltstyp dokumentieren, damit ein rechtlicher Review nicht zufällig bei jedem Format ansetzt, aber bei Vertragsunterlagen in jeder Sprache pflichtig ist. Drittens: Jede Rolle prüft genau einmal, denn wer zweimal gefragt wird, antwortet irgendwann nicht mehr.
Der Kern-Workflow: Von der Quellfreigabe bis zur Veröffentlichung
Der häufigste und teuerste Fehler beginnt vor der ersten Übersetzung: Ein Quellinhalt wird parallel zur Lokalisierung weiter überarbeitet. Jede Korrektur am Original vervielfacht sich dann über alle Zielsprachen, weil jede Sprachfassung einzeln nachgezogen werden muss. Deshalb gilt die erste Regel jedes Enterprise-Workflows: Der Quellinhalt geht erst in die Lokalisierung, wenn er final freigegeben ist. Ein konsequentes Localization-First-Vorgehen, wie es das Playbook zur Lokalisierung beschreibt, setzt genau an dieser Schnittstelle an.
- Quellfreigabe: Der Originalinhalt ist inhaltlich, rechtlich und markenseitig abgenommen und wird eingefroren.
- Übersetzung bzw. Post-Editing: Maschineller Entwurf oder Fachübersetzung, je nach Risiko des Inhaltstyps.
- Linguistische Prüfung: Ein professioneller Linguist prüft Grammatik, Stil und Terminologie der Sprachfassung.
- In-Country-Review: Muttersprachler und Fachexperte im Zielland prüfen Markttauglichkeit und kulturelle Passung.
- Technische QA: Formate, Untertitel-Timing, Audio-Synchronisation, Layout und Links werden verifiziert.
- Finale Abnahme: Der Approver erteilt das formale Zeichen je Sprache.
- Veröffentlichung: Auslieferung über die geplanten Kanäle, danach Archivierung des Freigabe-Nachweises.
Zwei Designentscheidungen bestimmen die Durchlaufzeit. Erstens die Wahl zwischen linearer und paralleler Abnahme: Bei ButterCMS läuft im linearen Prozess jede Stufe nacheinander, im parallelen Prozess prüfen mehrere Stellen gleichzeitig, was bei komplexen Inhalten schneller, aber koordinationsaufwändiger ist[3]. Als Faustregel eignet sich der Parallellauf für risikoarme Inhalte wie Social-Clips, während rechtlich sensible Formate linear laufen. Zweitens braucht jede Stufe ein definiertes Kriterium für Weitergabe oder Rückweisung, etwa einen LQA-Schwellenwert oder eine Checkliste. Ohne dieses Kriterium wird die Stufe zur Geschmacksfrage, und Geschmacksfragen sind die teuersten Schleifen im Prozess.
In-Country-Review als Qualitätsschritt richtig einsetzen
Beim In-Country-Review prüft ein Muttersprachler im Zielland die Übersetzung, typischerweise eine Mitarbeiterin oder ein Mitarbeiter am Zielstandort, der beide Sprachen beherrscht und den Markt kennt[4]. Die Stufe ist unverzichtbar, denn hier entscheidet sich, ob der Inhalt im Markt wirklich funktioniert. Sie ist in der Praxis aber auch der langsamste Schritt: Diese Reviewer sind meist keine professionellen Linguisten, sondern arbeiten die Prüfung neben ihrem eigentlichen Job ab, oft mit begrenztem Kontext und ohne Zugriff auf Glossare und Styleguides. Die Folge sind Rückfragen, zusätzliche Prüfrunden und Verzögerungen.
- Früh einbinden: Reviewer bereits bei der Inhaltserstellung einbeziehen statt erst am Ende, und ihnen Glossare sowie Styleguides bereitstellen, damit sie nicht gegen unbekannte Vorgaben prüfen.
- Im Kontext prüfen: Review im fertigen Layout, im Video und im Ton statt isolierter Textschnipsel, denn ein Satz, der im Editor korrekt wirkt, kann im Untertitel oder gesprochenen Skript brechen.
- Feedback strukturiert zurückführen: Änderungen der Reviewer systematisch erfassen und in Translation Memories sowie Glossare einspeisen, damit künftige Projekte von diesen Korrekturen profitieren und dieselben Fehler nicht erneut diskutiert werden.
Der letzte Punkt ist der am häufigsten verpasste Hebel. Wenn die Korrekturen eines In-Country-Reviewers einmalig in die Sprachdaten fließen, muss der Reviewer sie nie wieder machen: Jede spätere Sprachfassung startet auf dem korrigierten Stand, wodurch Prüfrunden und Durchlaufzeit sinken. Der Schritt-für-Schritt-Aufbau einer solchen Lokalisierungskette, von der Transkription bis zum Mischen der Sprachfassungen, lässt sich gut am Beispiel eines Podcast-Workflows nachvollziehen.
Qualität messbar machen: LQA-Scores und Abnahmekriterien
Bauchgefühl ist kein Abnahmekriterium. Die linguistische Qualitätssicherung (LQA) ersetzt es durch objektive Fehlerkategorien und Scorecards, wie sie auf dem MQM-Framework (Multidimensional Quality Metrics) aufbauen: einem hierarchischen Katalog von Fehlertypen unter sieben Kerndimensionen wie Accuracy, Fluency, Terminology und Style, mit zugeordneten Schweregraden und einer Scoring-Formel, die aus Fehlern einen numerischen Qualitätswert berechnet[5]. Fehler werden also gezählt und gewichtet, nicht diskutiert.
| Schweregrad | Wirkung auf den Inhalt | Multiplikator (MQM-Standard) |
|---|---|---|
| Neutral | Akzeptable Alternative, nur zur Kenntnis des Übersetzers markiert | 0 |
| Minor | Begrenzte Auswirkung auf Verständlichkeit oder Stil | 1 |
| Major | Erheblich beeinträchtigt Verständlichkeit, Verlässlichkeit oder Nutzung | 5 |
| Critical | Macht den Inhalt unbrauchbar oder birgt schweres Risiko, löst in vielen Systemen automatisch ein Fail aus | 25 |
Auf dieser Basis lassen sich Abnahmeschwellen je Inhaltstyp definieren: Marketinginhalte mit hohem Sichtbarkeitsgrad verdienen strengere Grenzen und höhere Gewichtung für Stil- und Zielgruppenfehler, während interne Schulungsunterlagen eher an Accuracy und Terminologie gemessen werden. Das MQM-Modell sieht dafür eigene Gewichtungen je Fehlertyp vor und arbeitet bei hohen Volumina mit Stichproben von typischerweise 500 bis 20.000 Wörtern, während eine Vollprüfung risikoreichen Inhalten wie Rechts- oder Medizinformaten vorbehalten bleibt[5]. So bleibt der Prüfaufwand skalierbar, ohne den Freigabestandard dem Zufall zu überlassen.
Feedback-Schleifen und Versionierung beherrschen
Verstreutes Feedback ist der stille Budgetfresser der Lokalisierung. Kommentare in E-Mails, Chats und separaten Dokumenten führen zu Versionsverwirrung, übersehenen Einwänden und erneutem Rework. Organisationen, die ihre Review-Prozesse zentralisieren und strukturieren, erreichen laut zipBoard dagegen bis zu 50 % schnellere Freigaben und bis zu 50 % weniger Revisionsschleifen[6]. Der Effekt kommt nicht aus dem Tool allein, sondern daraus, dass jeder Kommentar an einer Version hängt und jede Entscheidung einen Verantwortlichen hat.
- Versionskontrolle: Jeder Review-Zyklus läuft gegen eine eindeutige Version, damit niemand mehr veraltete Entwürfe kommentiert und Korrekturen doppelt ansetzen.
- Audit-Trail: Wer was wann freigegeben hat, ist lückenlos dokumentiert, was bei regulierten Inhalten und internen Eskalationen die Grundlage für Nachweise bildet.
- Automatisierte Workflows: Routing, Erinnerungen und Statusverfolgung laufen automatisch, was manuelle Abstimmung reduziert und die Durchlaufzeit von Prüf- und Freigabeschritten verkürzt[7].
- Kommunikationskosten im Blick: Schlechte Kommunikation kostet US-Unternehmen laut dem State of Business Communication Report von Grammarly und Harris Poll rund 12.506 US-Dollar pro Mitarbeiter und Jahr[8], ein Betrag, der sich in verlorenen Review-Stunden direkt wiederfindet.
Für Enterprise-Teams heißt das: Feedback ist ein Workflow-Schritt mit Frist, Version und Verantwortlichem, kein E-Mail-Verkehr am Rand. Genau diese Disziplin macht Freigaben planbar, denn eine Freigabe, deren Vorlaufzeit niemand kennt, ist im Veröffentlichungskalender keine.
Skalieren: Automatisiertes Routing mit menschlicher Endabnahme
Das Zielbild für Enterprise-Teams ist kein Workflow ohne Menschen, sondern ein Workflow, der Menschen gezielt einsetzt. Routing-Regeln entscheiden automatisch, welcher Inhalt maschinell übersetzt wird und wann ein Mensch prüft. Dass die menschliche Endabnahme dabei nicht wegfällt, zeigt die Praxis deutlich: 99 % der im DeepL-Bericht befragten Marketingverantwortlichen lassen maschinelle Übersetzungen von einem Menschen prüfen[9]. Der Freigabe-Workflow ist also nicht der Gegenspieler der Automatisierung, sondern ihre Voraussetzung.
- Terminologie einbetten: Glossare und Terminologiedatenbanken gehören direkt in den Workflow, denn 82 % der Befragten nannten branchenspezifische Terminologie als größte Herausforderung der Übersetzung[9].
- Zentraler Workspace: Übersetzung, Re-Voicing und Packaging in über 100 Sprachen laufen in einem Ort zusammen, sodass alle Freigabestufen auf derselben Version arbeiten statt über Toolgrenzen hinweg.
- Metriken auswerten: Durchlaufzeit je Stufe, Anzahl der Revisionsrunden und LQA-Score werden regelmäßig ausgewertet und in Anpassungen an Rollen, Schwellen und Routing-Regeln übersetzt.
Genau hier schließt sich der Kreis zum Werkzeug: Ein KI-nativer Lokalisierungs-Workspace wie ContentHub Studio von Dictem hält Quellinhalt, Sprachfassungen, Review-Status und Freigaben an einem Ort, statt sie über Übersetzungstools, Untertitel-Editoren und E-Mail-Ketten zu verteilen. Wer zusätzlich die Auswahlkriterien für Tools zur Content-Lokalisierung kennt, kann Workflow und Plattform gemeinsam aufsetzen, statt beides getrennt zu denken. Der eigentliche Vorsprung entsteht dann nicht aus der schnellsten Übersetzungsengine, sondern aus einem Freigabe-Workflow, der jede Runde messbar schneller und jede Sprachfassung messbar besser macht.
Häufige Fragen
Was ist ein Freigabe-Workflow in der Content-Lokalisierung?
Ein Freigabe-Workflow ist die definierte Kette von Prüf- und Abnahmeschritten, die mehrsprachige Inhalte durchlaufen, bevor sie veröffentlicht werden: Quellfreigabe, Übersetzung bzw. Post-Editing, linguistische Prüfung, In-Country-Review, technische QA und finale Abnahme. Jede Stufe hat ein klares Kriterium für Weitergabe oder Rückweisung und eine verantwortliche Rolle.
Wer sollte an einem Lokalisierungs-Freigabeprozess beteiligt sein?
Typische Rollen sind Anforderer, Lokalisierungsmanager, Übersetzer bzw. Post-Editor, Fachexperten für den Inhalt, Legal- und Compliance-Prüfer bei regulierten Inhalten sowie der finale Approver. Wichtig ist die Trennung: Reviewer geben Feedback, Approver erteilen das formale Zeichen. Rollen sollten nach Expertise und Sprache zugewiesen werden, nicht nach Hierarchie.
Warum ist der In-Country-Review so wichtig und oft so langsam?
Der In-Country-Reviewer ist meist ein Mitarbeiter im Zielland, Muttersprachler und Fachexperte zugleich, aber kein professioneller Linguist und prüft neben dem Tagesgeschäft. Ohne Glossare, Styleguides und Kontext (Layout, Bild, Ton) entstehen Nachfragen, zusätzliche Prüfrunden und Konflikte mit der Zentrale. Frühe Einbindung und Prüfung im Kontext verkürzen den In-Country-Review deutlich.
Wie misst man die Qualität lokalisierter Inhalte objektiv?
Mit linguistischer Qualitätssicherung (LQA): Übersetzungen werden gegen ein Schema objektiver Fehlerkategorien bewertet, häufig auf Basis des Multidimensional-Quality-Metrics-Frameworks, und zu einem numerischen Qualitätswert verrechnet. Daraus leitet man Abnahmeschwellen je Inhaltstyp ab, etwa strengere Kriterien für Marketing als für interne Schulungsunterlagen.
Lohnt sich Lokalisierung für Unternehmen überhaupt wirtschaftlich?
Ja. In der DeepL-Studie 2023-2024 gaben 96 % der befragten Marketer einen positiven ROI ihrer Lokalisierungsarbeit an, 65 % berichteten sogar von mindestens einem dreifachen ROI. Effiziente Freigabeprozesse werden damit zum Wettbewerbsfaktor, denn sie entscheiden darüber, wie viel von diesem Potenzial tatsächlich veröffentlicht wird.
Wie viel Automatisierung ist im Freigabe-Workflow sinnvoll?
Automatisierung sollte das Routing und die Koordination übernehmen: Regeln entscheiden, welcher Inhalt maschinell übersetzt wird und wann ein Mensch prüft. Die finale Abnahme bleibt beim Menschen, denn 99 % der befragten Marketingverantwortlichen kombinieren maschinelle Übersetzung mit menschlicher Prüfung. Automatisierte Freigabeworkflows reduzieren zusätzlich den manuellen Abstimmungsaufwand und verkürzen die Durchlaufzeit.
Was sind die häufigsten Fehler beim Aufsetzen eines Lokalisierungs-Freigabeworkflows?
Die klassischen Fehler: Quellinhalte wandern vor der finalen Freigabe in die Lokalisierung, Feedback verstreut über E-Mail und Chat statt in einer Plattform, Reviews laufen auf veralteten Versionen, und es gibt keine dokumentierten Abnahmekriterien. Die Folge sind Endlosschleifen und verpasste Termine. Zentralisiertes Feedback mit Versionskontrolle und Audit-Trail verkürzt solche Revisionszyklen deutlich.
Quellen
Bereit, global zu gehen?
Übersetze, vertone und verpacke deine Inhalte für jede Sprache, mit Dictem.
Dictem Studio öffnen